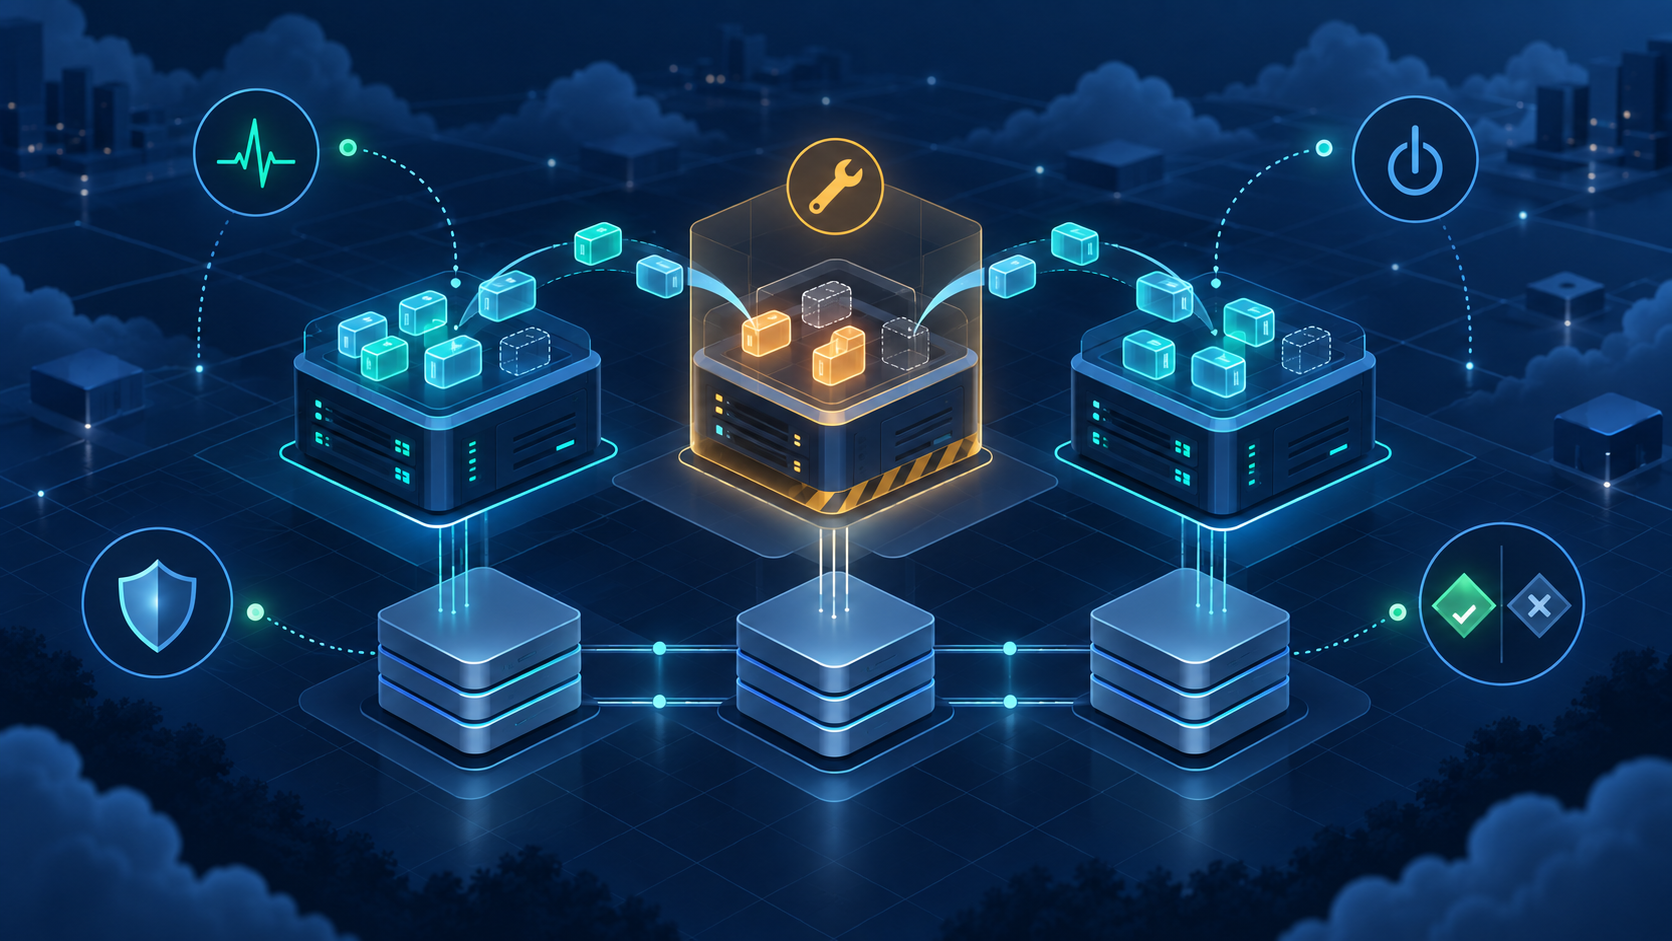


Kubernetes bakımında “node’u drain edip güncellemek” tek başına kesintisiz operasyon planı değildir. PodDisruptionBudget yanlış tanımlanmışsa tahliye durabilir; doğru tanımlanmış olsa bile uygulamanın gerçek kapasitesi yeni replica’yı taşıyamayabilir. Güvenli bir Kubernetes bakım penceresi, PDB, drain davranışı, yedek kapasite, storage ve uygulama sağlık sinyallerini tek akışta ele alır.
Bakım penceresinin başarı ölçütünü baştan yazın
Bakımın hedefi yalnızca node sürümünü yükseltmek değildir. Kullanıcı hatası, istek gecikmesi, kuyruk yaşı ve kritik iş akışları kabul edilen sınırlar içinde kalmalıdır. Başlangıçtan önce normal durum ölçümlerini kaydedin: hazır replica sayısı, node başına kaynak baskısı, hata oranı, p95 yanıt süresi ve bekleyen iş miktarı. Rollback veya durdurma kararı bu ölçümlerle verilir.
Plan; hangi node grubunun değişeceğini, aynı anda kaç node’un kullanılamaz olabileceğini, bakım sırasını ve sorumlu kişiyi açıkça belirtmelidir. “Sorun olursa geri döneriz” yerine geri dönüşün hangi sinyalde başlayacağı ve eski sürümün nasıl korunacağı yazılmalıdır.
PodDisruptionBudget neyi korur, neyi korumaz?
PDB, gönüllü kesintiler sırasında aynı anda kaç Pod’un kullanılamaz olabileceğini eviction mekanizmasına bildirir. minAvailable ile minimum hazır kopya, maxUnavailable ile izin verilen kayıp tanımlanabilir. İki alan aynı PDB’de birlikte kullanılmaz. Seçici etiketlerin gerçekten hedef workload’u eşlediği doğrulanmalıdır.
PDB bir yüksek erişilebilirlik garantisi değildir. Node arızası gibi gönülsüz kesintileri engellemez; uygulama readiness kontrolü yanlışsa gerçekte hizmet veremeyen bir Pod hazır görünebilir. Tek replica’lı bir Deployment için minAvailable: 1 tanımı drain’i doğal olarak durdurur. Bu bir Kubernetes hatası değil, bakım ile kullanılabilirlik hedefinin çeliştiğini gösteren korumadır.
- PDB selector’ünü canlı Pod etiketleriyle karşılaştırın.
- Deployment replica sayısı ile minimum hazır değerini birlikte okuyun.
- Readiness probe’un gerçek bağımlılıkları temsil ettiğini test edin.
- Eviction’ın neden beklediğini olay ve API çıktısından doğrulayın.
Drain öncesi yedek kapasite hesabı
Bir node boşaltıldığında workload diğer node’lara yerleşebilmelidir. Toplam CPU ve RAM’in boş görünmesi yeterli değildir; Pod request değerleri, topology spread kuralları, node affinity, taint/toleration, port kullanımı ve zone kısıtları scheduler kararını etkiler. Büyük bir Pod için cluster genelinde yeterli toplam kaynak olsa bile tek bir node’da gerekli kesintisiz boşluk bulunmayabilir.
Bakım öncesinde hedef node’daki Pod’ları çıkarınca oluşacak request yükünü simüle edin. Kritik workload’lar için en az bir node kaybını taşıyacak pay olup olmadığını kontrol edin. Cluster autoscaler kullanılıyorsa yeni node’un hazır olma süresini bakım takvimine ekleyin; ölçekleme sinyalinin gelmesini beklemek, planlı işlemi gereksiz riskli hale getirir.
Stateful workload ve storage kontrolü
Stateless Pod’un yeniden yerleşmesi ile veritabanı veya tek node’a bağlı volume kullanan Pod’un taşınması aynı değildir. PersistentVolume erişim modu, CSI sürücüsünün detach/attach süresi, zone yerleşimi ve uygulamanın temiz kapanma davranışı incelenmelidir. Volume’un başka node’a bağlanabilmesi, uygulama seviyesinde veri tutarlılığını tek başına kanıtlamaz.
- StatefulSet sırası ve Pod management policy’sini kontrol edin.
- Volume snapshot veya yedek işinin son başarılı sonucunu doğrulayın.
- Detach/attach süresini gerçek ölçümle bakım bütçesine ekleyin.
- Tek zone bağımlılığı olan workload’ları ayrı risk olarak işaretleyin.
- Restore prosedürünü snapshot alma işleminden bağımsız olarak test edin.
Güvenli cordon ve drain akışı
Önce node’u cordon ederek yeni Pod yerleşimini durdurun. Ardından birkaç dakika gözlemleyin: scheduler bekleyen işleri başka node’lara taşıyor mu, kapasite alarmı oluşuyor mu, DaemonSet dışındaki kritik Pod’lar hedef node’a bağlı kalıyor mu? Bu kısa bekleme, drain başlamadan önce yanlış node veya kapasite varsayımını yakalayabilir.
Drain sırasında DaemonSet Pod’larının davranışı, local data kullanan Pod’lar ve grace period bilinçli ele alınmalıdır. PDB’yi aşmak için zorlayıcı seçenekleri varsayılan çözüm haline getirmeyin. Tahliye takılıyorsa korumayı kapatmak yerine hangi workload’un neden taşınamadığını bulun. Özellikle tek replica, hatalı readiness veya yetersiz request tanımı çoğu zaman asıl nedendir.
Uygulama bağlantıları ve uzun süren işler
Pod sonlandırma sinyali aldıktan sonra yeni trafik kabulünü bırakmalı, devam eden isteklere makul süre tanımalı ve bağlantıları kontrollü kapatmalıdır. terminationGracePeriodSeconds değeri uygulamanın gerçek kapanma süresine göre ayarlanmalıdır. Çok kısa süre veri veya iş kaybı yaratabilir; gereksiz uzun süre ise bakımın tıkanmasına yol açabilir.
Kuyruk tüketicilerinde yeni iş alma durdurulmalı, eldeki iş bitirilmeli veya görünür biçimde tekrar kuyruğa bırakılmalıdır. WebSocket, gRPC stream ve uzun rapor görevleri için yük dengeleyici ile uygulamanın bağlantı boşaltma davranışı birlikte test edilmelidir. Sadece Pod durumuna bakmak müşteri deneyimini göstermeyebilir.
Bakım sırasında izlenecek sinyaller
- Hazır ve istenen replica sayısı arasındaki fark
- Pending Pod ve başarısız scheduling olayları
- Uygulama hata oranı ve p95/p99 yanıt süresi
- Ingress 5xx, bağlantı reset ve upstream timeout sayısı
- Kuyruk yaşı, tüketim hızı ve tekrar deneme oranı
- Node memory/disk pressure ve image pull süresi
- Volume attach/detach olayları ve storage gecikmesi
Her metrik için tek bir evrensel eşik yoktur. Bakım öncesi baseline ile kabul edilebilir sapmayı birlikte tanımlayın. Teknik metrikler yeşil olsa bile login, ödeme, kayıt veya dosya yükleme gibi kritik sentetik kontroller başarısızsa ilerlemeyi durdurun.
Bakım sonrası doğrulama ve geri dönüş
Node Ready durumuna geldiğinde iş bitmez. Kubelet ve runtime sürümünü, CNI/CSI/DaemonSet sağlığını, sertifika ve log durumunu kontrol edin. Node’u tekrar schedulable yaptıktan sonra Pod dağılımının dengeli olduğunu ve eski node’a beklenmeyen yoğunlaşma olmadığını gözleyin. Sonraki node’a ancak doğrulama kapısı geçildikten sonra ilerleyin.
Rollback, yalnızca eski binary’yi kurmak olmayabilir. Control plane ile node sürüm uyumluluğu, veri şeması değişiklikleri ve addon sürümleri geri dönüş yolunu etkiler. Önceden alınmış konfigürasyon yedeği ve sürüm matrisi olmadan bakım sırasında yeni bir geri dönüş tasarlamak risklidir.
Kubernetes bakım penceresi kontrol listesi
- Başlangıç metrikleri ve rollback eşikleri kaydedildi.
- PDB selector, replica sayısı ve readiness davranışı doğrulandı.
- Bir node kaybını taşıyacak yerleşebilir kapasite mevcut.
- Affinity, topology spread ve taint kısıtları incelendi.
- Stateful workload ve volume taşıma süresi test edildi.
- Uygulama kontrollü kapanma ve bağlantı boşaltmayı destekliyor.
- Sentetik iş akışı kontrolleri hazır.
- Her node sonrası dur/onay kapısı tanımlı.
Kubernetes kapasite, HA, ingress ve storage kararlarını bakım modeliyle birlikte ele almak için Kubernetes Cluster Hosting hizmetini inceleyebilir veya mevcut yapınız için teknik değerlendirme talebi oluşturabilirsiniz.