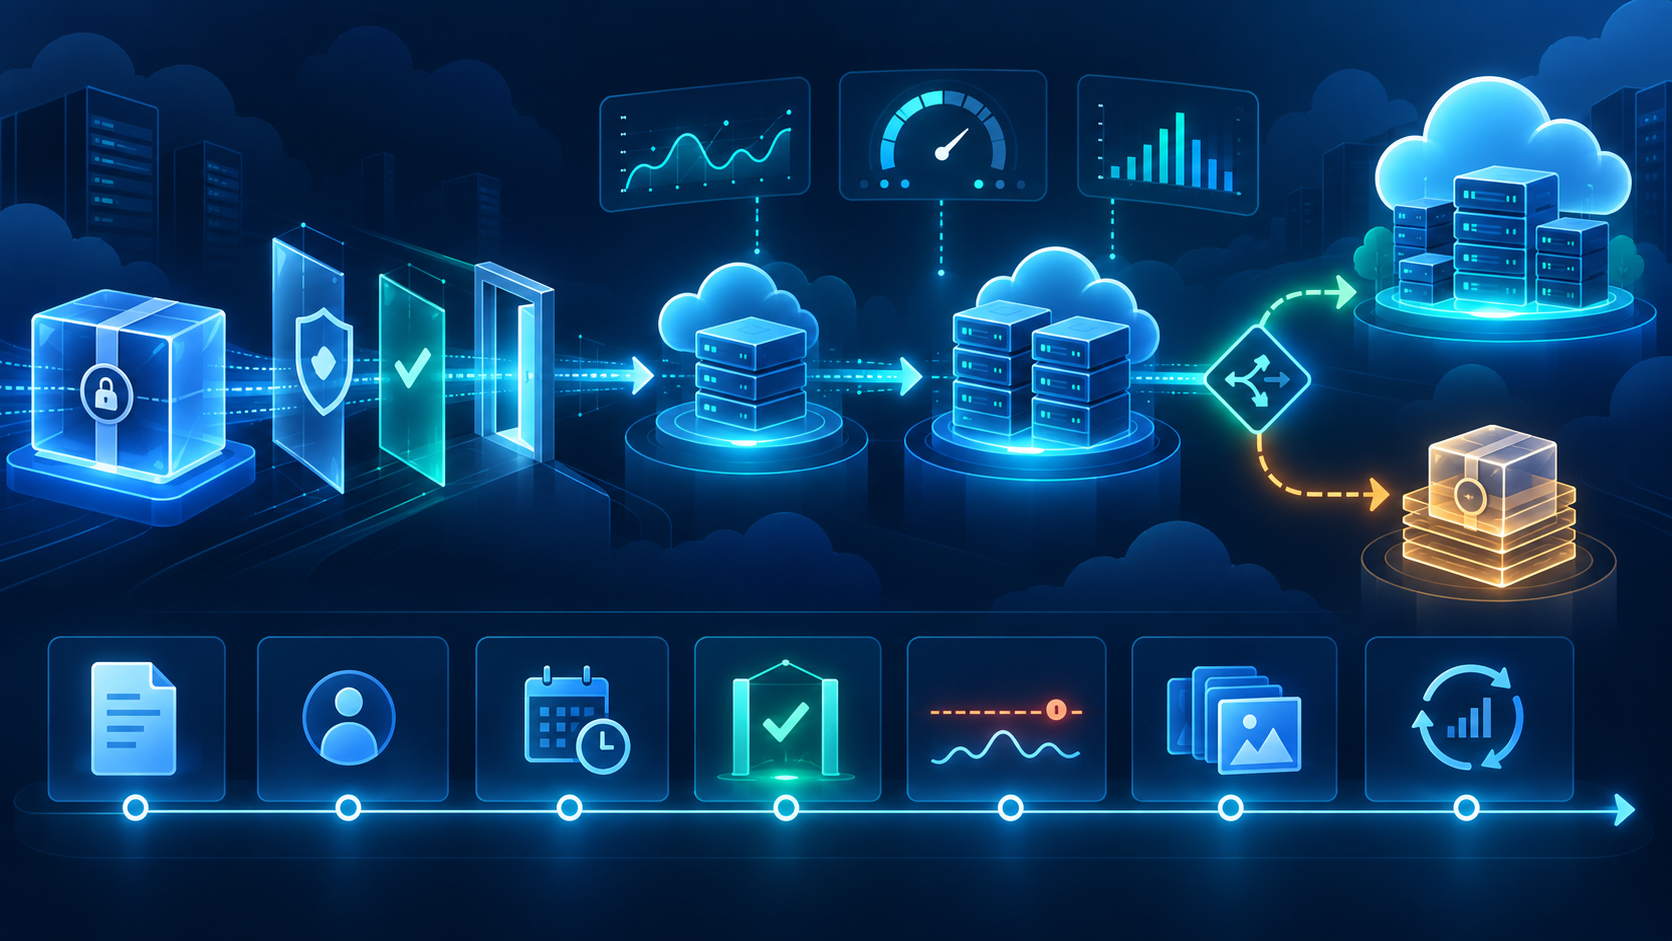


Production değişikliklerinde en pahalı hata çoğu zaman hatalı koddan değil, karar belirsizliğinden doğar: Dağıtımı kim onayladı, hangi metrik bozulursa durulacak, geri dönüş ne kadar sürecek ve hangi sürümün güvenli olduğu nasıl doğrulanacak? Bu sorular değişiklik başlamadan cevaplanmadığında ekip, olay anında hem teşhis hem süreç tasarımı yapmak zorunda kalır.
Bakım penceresi tek başına kontrol değildir
Bir değişikliği gece saatine almak riski azaltabilir; fakat başarısızlığın erken fark edileceğini veya geri dönüşün çalışacağını garanti etmez. Güvenli bakım modeli; kapsam, bağımlılıklar, sorumlu kişi, gözlem süresi, durdurma eşiği ve geri dönüş komutlarını aynı değişiklik kaydında bir araya getirir. “Gerekirse rollback yaparız” ifadesi plan değildir; hangi koşulda, kimin kararıyla ve hangi varlığa dönüleceği açık olmalıdır.
Değişiklik kaydının asgari alanları
Değişiklik kaydı uzun bir bürokrasi belgesi olmak zorunda değildir. Ama uygulamayı yapan kişi dışında bir ekip üyesinin ne değişeceğini, riski ve geri dönüşü anlayabileceği kadar somut olmalıdır. Özellikle ajanslar ve SaaS ekiplerinde aynı kişi hem geliştirici hem sistem yöneticisi rolündeyse yazılı kayıt, kritik bilgiyi kişiden bağımsız hâle getirir.
- Amaç: Hangi iş veya teknik problem çözülüyor?
- Kapsam: Uygulama, veritabanı, ağ, domain, sertifika ve bağımlı servislerden hangileri etkileniyor?
- Risk: Olası kullanıcı etkisi ve veri bütünlüğü riski nedir?
- Sorumlular: Uygulayan, onaylayan ve gözlemleyen kişiler kim?
- Ön koşullar: Yedek, snapshot, kapasite ve sağlık kontrolleri tamam mı?
- Uygulama adımları: Sıralı, tekrar edilebilir ve durma noktaları belirli mi?
- Doğrulama: Hangi teknik ve iş metrikleri kontrol edilecek?
- Rollback: Tetikleyici eşik, komutlar, veri uyumluluğu ve tahmini süre nedir?
Go/no-go kapısını ölçülebilir kurun
Değişiklik başlamadan hemen önce kısa bir go/no-go kontrolü yapılmalıdır. Son yedeğin zamanı, mevcut hata oranı, kapasite baskısı, devam eden başka bakım işleri ve ekip erişilebilirliği bu kararı etkiler. Sistem zaten normal dışı davranıyorsa yeni değişiklik teşhisi zorlaştırır. Kritik bir bağımlılıkta olay varsa bakım ertelenebilir.
“Sistem iyi görünüyor” yerine başlangıç değerlerini kaydedin: uygulama hata oranı, p95 yanıt süresi, kuyruk gecikmesi, veritabanı bağlantı kullanımı, CPU/RAM/disk baskısı ve kritik iş işleminin başarı oranı. Değişiklik sonrasındaki karşılaştırma bu baseline üzerinden yapılır.
Rollback eşiğini değişiklikten önce belirleyin
Rollback kararı duygusal veya unvana bağlı olmamalıdır. Hata oranı belirli süre boyunca yükselirse, kritik işlem başarısız olursa, veri uyumsuzluğu görülürse veya gözlem penceresi içinde neden açıklanamıyorsa geri dönüş tetiklenebilir. Eşiğin hizmete göre değişmesi normaldir; önemli olan kararın production baskısı başlamadan verilmesidir.
- Kritik endpoint’in health check’i başarısız.
- Hata oranı baseline’ın belirlenen katına çıktı ve birkaç dakika içinde düşmedi.
- Veritabanı migration’ı beklenenden uzun sürüyor veya lock baskısı oluşturuyor.
- Kuyruk gecikmesi iş hedefini aşacak hızda büyüyor.
- Ödeme, sipariş, oturum açma gibi temel iş akışı başarısız.
- Log ve metrik görünürlüğü kaybolduğu için güvenli doğrulama yapılamıyor.
Uygulama rollback’i ile veri rollback’i aynı değildir
Önceki container image veya release paketine dönmek görece kolay olabilir. Veritabanı şema değişikliği ise eski uygulamayla uyumsuz hâle gelebilir. Bu nedenle migration’lar mümkün olduğunca geriye uyumlu ve aşamalı tasarlanmalıdır. Önce yeni alanı eklemek, iki sürümün birlikte çalışmasını sağlamak, veri dönüşümünü arka planda tamamlamak ve eski alanı ayrı bir değişiklikte kaldırmak çoğu zaman daha güvenlidir.
Rollback planı ayrıca DNS TTL, cache, mesaj kuyruğu şeması, arka plan job’ları ve haricî entegrasyonları kapsamalıdır. Uygulama sürümü geri dönse bile yeni formatta üretilmiş mesajlar eski consumer tarafından okunamıyorsa olay devam eder.
Kademeli dağıtım ve gözlem penceresi
Tüm trafiği tek adımda yeni sürüme yönlendirmek yerine uygun sistemlerde canary, rolling veya blue-green yaklaşımı kullanılabilir. Fakat isim seçmek yeterli değildir. Yeni sürüme giden trafik oranı, gözlem süresi, başarı ölçütü ve otomatik/manuel ilerleme kararı tanımlanmalıdır. Düşük trafikli B2B sistemlerde yalnızca yüzdesel canary yanıltıcı olabilir; temsilî sentetik işlem ve belirli müşteri senaryoları da çalıştırılmalıdır.
Kanıt üretin: değişiklik sonrası kayıt
Bakım tamamlandığında yalnızca “başarılı” notu bırakmayın. Başlangıç ve bitiş zamanı, uygulanan sürüm, doğrulanan metrikler, varsa sapmalar, rollback gerekip gerekmediği ve sonraki aksiyonlar kaydedilmelidir. Dashboard ekran görüntüsü yerine mümkünse sorgulanabilir metrik bağlantısı, deployment kimliği ve log korelasyon bilgisi kullanın. Böylece sonraki değişikliklerde tahmin yerine geçmiş kanıtla süre ve risk planlanabilir.
SLA, SLO ve bakım modeli nasıl bağlanır?
SLA müşteriye verilen hizmet taahhüdünü; SLO ise ekibin yönettiği ölçülebilir hedefi ifade eder. Bakım süreci, hata bütçesini ve kullanıcı etkisini dikkate almalıdır. Her değişiklik “sıfır kesinti” iddiasıyla sunulmamalı; mimari buna uygun değilse kontrollü bakım penceresi daha gerçekçi olabilir. Hedef, hiçbir zaman değişiklik yapmamak değil; değişikliğin beklenen etkisini ölçmek ve başarısız olduğunda hızlı, kanıtlanmış bir geri dönüş sağlamaktır.
Eskalasyon ve iletişim planını teknik planla birleştirin
Teknik olarak doğru bir bakım, kullanıcı ve ekip iletişimi eksik olduğunda yine başarısız algılanabilir. Değişiklik kaydında hangi durumda bakım sorumlusunun tek başına ilerleyebileceği, hangi durumda uygulama veya veritabanı sahibinin çağrılacağı ve müşteriye ne zaman bilgi verileceği belirlenmelidir. Kritik alarm için yalnızca mesaj göndermek yeterli değildir; mesajın bir sorumlu tarafından kabul edildiğini gösteren eskalasyon zinciri gerekir.
Planlı pencere aşılırsa yeni bir bitiş tahmini vermeden önce sistemin hangi durumda olduğunu açıklayın: Yeni sürüm gözlemde mi, rollback başladı mı, veri doğrulaması mı bekleniyor? Değişiklik sonrası kısa değerlendirmede teknik sonuçla birlikte iletişim gecikmeleri, yanlış alarm eşikleri ve erişim sorunları da kaydedilmelidir. Bu kayıtlar, sonraki bakım için gerçekçi süre ve nöbet planı oluşturur.
Production değişikliği için kısa kontrol listesi
- Kapsam, risk ve bağımlılıklar yazıldı.
- Uygulayan, onaylayan ve gözlemleyen kişiler belirlendi.
- Yedek/snapshot doğrulandı; geri yükleme sorumlusu belli.
- Başlangıç metrikleri kaydedildi.
- Go/no-go ve rollback eşikleri sayısallaştırıldı.
- Veritabanı ve mesaj formatı geriye uyumluluğu kontrol edildi.
- Kademeli dağıtım adımları ile bekleme süreleri tanımlandı.
- Kritik kullanıcı yolculuğu sentetik olarak test edildi.
- Rollback adımları mümkünse staging’de prova edildi.
- Değişiklik sonrası kanıt ve öğrenimler kayda geçirildi.
DevOps bakımını kişiye bağlı olmaktan çıkarın
Narweb DevOps Hizmeti; deployment, izleme, yedekleme ve güvenli production sunucu operasyonlarını ölçülebilir bakım adımlarıyla ele alır. Mevcut sisteminizde değişiklik kaydı, gözlem kapıları ve rollback hazırlığını değerlendirmek için teknik ekibimizle görüşebilirsiniz.